TL;DR
Fireworks es una plataforma de Specialized Intelligence de modelos abiertos y propios fundada en 2022 por ingenieros ex Meta (incluido el equipo fundador del núcleo de PyTorch) / Google, con sede en San Mateo, California.
Su pila, de abajo arriba, son seis módulos: Infrastructure (Cloud + Sovereign) → Training → Fireworks Lab → Models (propios / biblioteca abierta / pesos del cliente) → Inference → Model ensembling (Nexus + API).
Fireworks revela que de los más de 40 billones (40T+) de tokens que procesa al día, más del 95% no son llamadas directas a pesos abiertos públicos, sino modelos propietarios afinados, entrenados con aprendizaje por refuerzo (RL) u optimizados en parámetros con datos privados del cliente. Si el 90% del tráfico de una plataforma corre Llama o DeepSeek públicos, es un mayorista de cómputo público; cuando el 95% de la salida son modelos propietarios procesados a medida para distintos clientes, tiene el atributo de TSMC (Foundry).
Figura 1. Mezcla de tokens en la Serie D. Divulgación de la compañía, julio de 2026.
Equipo y desarrollo
Historia de financiación
| Ronda | Fecha | Importe | Post-money | Líderes, accionistas estratégicos y estructura |
|---|---|---|---|---|
| Series A | 2024-03 | $25M | — | Benchmark líder; Sequoia y otros |
| Series B | 2024-07 | $52M | $552M | Sequoia líder; estratégicos NVIDIA, AMD, MongoDB, Databricks y otros |
| Series C | 2025-10 | $250M | $4.0B | Unos $230M primarios + $20M secundarios; Lightspeed, Index, Evantic líderes; financiación acumulada declarada > $327M |
| Series D | 2026-07 | $1.505B | $17.5B | Atreides, Index, TCV coleader; NVIDIA, Evantic, Lightspeed, BVP, Insight, Lone Pine, Menlo, Ontario Teachers' participan; capital primario acumulado $1.83B |
| Tender Offer (secundario de empleados) | 2026-09 | $132M | — | Anunciado 2026-09-25: tender de $132M liderado por Atreides para liquidez secundaria de empleados; el efectivo no entra en la compañía |
| Siguiente ronda rumoreada | 2026-10 | En conversaciones | $30B–$40B | Rumor de contactos de inversores tempranos, no anunciado; el portavoz de la compañía declinó comentar |
Instantánea Series C (2025-10): 10.000+ compañías; > 10T tokens/día; ARR > $280M. Instantánea Series D (2026-07): ya > 40T tokens/día; ARR > $1B+; > 95% de los tokens de modelos especializados con datos propietarios del cliente u optimizados para un trabajo concreto.
Equipo fundador y equipo estable
Siete cofundadores: Lin Qiao, Dmytro Dzhulgakov, Benny Chen, Chenyu Zhao, Dmytro Ivchenko, James Reed, Pawel Garbacki. Cerca de la mitad vinieron del equipo original de PyTorch.
| Cofundador | Rol previo (/team) | Bosquejo actual | Rebanada de capacidad |
|---|---|---|---|
| Lin Qiao | Head of PyTorch at Meta | Co-Founder, CEO | Productización del framework, org de ingeniería de 300 personas, narrativa externa |
| Dmytro Dzhulgakov | PyTorch core maintainer at Meta | Co-Founder, CTO | Caffe2 / PyTorch / ONNX, AI de producción de Ads, gobernanza open source |
| Benny Chen | Meta ads infra lead | Co-Founder (producto temprano / arquitectura de infra) | Inferencia GPU/ASIC de Ads, planificación de capacidad, TCO |
| Chenyu Zhao | Google Vertex AI Lead | Co-Founder (infraestructura núcleo; el único fichaje de Google) | GCP MLOps / AutoML, multi-nube y GPU heterogéneas |
| Dmytro Ivchenko | PyTorch for ranking lead at Meta | Co-Founder, Engineer | TorchRec, train/serve de recomendación a escala, kernels |
| James Reed | PyTorch compiler at Meta | Co-Founder; su sitio personal cita inferencia multimedia | torch.fx / TorchScript / PiPPy / ONNX |
| Pawel Garbacki | Meta Newsfeed core ML lead | Co-Founder, Researcher | Ranking de News Feed, post-entrenamiento / RL, Nexus / Ember-1 |
Lin Qiao — Co-Founder, CEO
- Educación: Grado y máster en informática, Universidad de Fudan; doctorado en informática, University of California, Santa Barbara (UCSB).
- Carrera: IBM desde circa 2003 (incluido el motor analítico BLU de Almaden Research); 2011–2015 LinkedIn, Tech Lead / Manager, en Espresso, Gobblin y el ciclo de vida de datos; se unió a Meta en 2015-07, gerente de Data Infrastructure, Senior Director of Engineering de 2018-02 a 2022-09. El equipo pasó de unos 5 a 300+, cubriendo Caffe2, PyTorch y la pila de train/serve de Meta. Línea pública: el equipo conservó el front end de PyTorch y reconstruyó el back end (incluido TorchScript); una migración de librería de 6 meses se convirtió en unos 5 años de reconstrucción de la pila, con una narrativa pico de más de 5 billones de inferencias al día.
Dmytro “Dima” Dzhulgakov — Co-Founder, CTO
- Educación / origen: Grado y máster en matemáticas aplicadas, NTU Kharkiv Polytechnic Institute; ucraniano. Fundó QBit, educación de programación para adolescentes, y un IDE de control industrial en NPF Informatica. Internships en Google Zurich y Facebook. Bio de X: “Ex-Pro Competitive Programmer.”
- Meta (circa 2011-12 a 2022-09): personalización de Ads y predicción de eventos a escala; desarrollador núcleo de Caffe2; coiniciador de la primera plataforma de AI de producción de toda Facebook; maintainer núcleo de PyTorch, uniendo investigación (FAIR) y toolchain de producto; ONNX; coautor del paper DLRM de 2019. Espejos de CV de terceros: org de 400+ en fase Tech Executive (Med).
Benny Chen (Benny Yufei Chen) — Co-Founder
- Educación / origen: Nacido en Nueva Zelanda. Entrevista Open Source CEO y podcast MindMakers: informática / Computer Science and Engineering en UCLA (circa 2015).
- Meta (unos 8–9 años, de intern a Principal): Ads infrastructure lead. En varias entrevistas: inferencia de modelos de ads en GPU y ASIC (él mismo: mover ads models a ASIC desde 2017, aún mundo V100); luego planificación de capacidad, vio la demanda interna de GPU “up and to the right”, la señal directa para dejar Meta y fundar.
Chenyu Zhao — Co-Founder (el único fichaje de Google)
- Educación: Grado en Electrical Engineering and Computer Science, UC Berkeley (Equilar).
- Google (unos diez años): Título oficial
/team: Google Vertex AI Lead. Bio de Slush 2026: senior engineering manager de la plataforma Google Cloud AI. Bosquejo de terceros: ayudó a construir Vertex AI, gestionó un equipo MLOps / AutoML de ~50 (Med). En una conversación pública AMD × Crusoe dijo venir de GCP.
Dmytro Ivchenko — Co-Founder, Engineer
- Educación / origen: Máster en análisis de sistemas, Igor Sikorsky Kyiv Polytechnic Institute; con Dzhulgakov, uno de los dos cofundadores ucranianos citados por la prensa.
- Carrera: Desarrollo en Bloomberg y FatWire; LinkedIn Senior Staff, lideró Galene y Recruiter; desde 2016 en Meta, Staff / Senior Staff / Principal. Oficial
/team: PyTorch for ranking lead.
James Reed (James K. Reed) — Co-Founder
- Educación: Grado en ingeniería informática, Virginia Tech, Summa Cum Laude. Internships en Google y Qualcomm.
- Meta: compilador de PyTorch. Staff Software Engineer; lideró o profundizó torch.fx, PiPPy (Pipeline Parallelism for PyTorch, luego fusionado en el núcleo de PyTorch), TorchScript, ONNX. Paper MLSys 2022 torch.fx: Practical Program Capture and Transformation for Deep Learning in Python (con Zach DeVito, Jason Ansel y otros). Patentes: predication in computational models (USPTO 10,553,207 y otras).
Pawel Garbacki (Paweł Garbacki) — Co-Founder, Researcher
- Educación / origen: Nacido en Varsovia. Grado/máster en matemáticas e informática, Universidad de Varsovia; máster en informática, VU Amsterdam; doctorado en informática, Delft + VU Amsterdam (director Dick Epema, OpenReview 2003–2008). Papers tempranos en P2P / Tribler.
- Carrera: Intern de investigación, IBM T.J. Watson; Google Staff / Tech Lead; 2013–2016 Pinterest, miembro fundador de Ads; 2016-10 a 2022-11 Meta Principal Engineer, News Feed Core Machine Learning.
Líneas de producto y modelo de negocio
Seis módulos de negocio
Posicionamiento de la compañía: no un Frontier Lab cerrado; un sistema operativo de Specialized Intelligence propiedad de la empresa — inferencia abierta + fine-tune/RL + orquestación, con coste y control apuntados a las API cerradas.
| Módulo del sitio | Producto | Cuándo el comprador elige este camino |
|---|---|---|
| 1. Infrastructure | A global GPU fleet, or Fireworks on your cloud. | La flota global es la base train-serve; residencia / air-gap / GPU propias → Sovereign / BYOC |
| 2. Training | Specialize open models. | Autoentrenamiento: Managed SFT/DPO/ORPO → Training API (incluido RL); si faltan algoritmos, Lab |
| 3. Fireworks Lab | Your research lab. Top frontier researchers, embedded in your team. | Coentrenamiento embebido cuando faltan algoritmos; misma pila train-serve que Training |
| 4. Models | Built by us, from the labs, or built by you. | Elegir/probar en Model library; pesos entrenados a Your models, misma pila que Inference a producción |
| 5. Inference | Serve open and custom models. | Prueba en Serverless; alto throughput estable / pesos propios / muchos LoRA en Dedicated; carga estable, Reserved Throughput (página de precios 99.9% SLA) |
| 6. Model ensembling | Intelligently combine models for your team's work and your applications. | Recortar la factura de código en el terminal con Nexus (Claude Code / Cursor / OpenCode por turno); multi-modelo in-app vía Fireworks API |
Módulo 1: Infrastructure
El cómputo base no está atado a la capacidad cloud propia de Fireworks.
- Fireworks Cloud (piscina global de GPU gestionada): 30+ regions, últimas NVIDIA + AMD, Foundry ciudadano de primera puede compensar el commit de Azure, ZDR / residencia regional / SOC 2 Type II / ISO 27001/42001
- Fireworks Sovereign (Fireworks on your cloud): la inferencia se queda en el K8s / cloud / centro del cliente; misma API, sin cambio de código; puede desbordar a Cloud.
Fireworks Cloud (piscina global de GPU gestionada)
Un Virtual Cloud alquilado a 20+ proveedores. Training Available solo en 5 regiones (Virginia / Ohio / Minnesota / Malasia / Taiwán). A100 sigue en Illinois; tres zonas AMD sin precio horario público. Fuentes: Microsoft Foundry (cuenta para Azure MACC); AWS Marketplace / SageMaker / Bedrock AgentCore; Google Cloud Marketplace.
| Región | Aceleradores | Training |
|---|---|---|
US_VIRGINIA_1 | H100 / H200 / B200 / B300 | Available |
US_OHIO_1 | B200 | Available |
US_MINNESOTA_1 | B300 | Available |
AP_MALAYSIA_2 | B300 | Available |
AP_TAIWAN_1 | GB300 | Available |
US_ARIZONA_1 | H100 | — |
US_CALIFORNIA_1 | H200 | — |
US_GEORGIA_2 / US_WASHINGTON_3/4/5 | B200 | — |
US_GEORGIA_3 | H200 | — |
US_ILLINOIS_1 / US_IOWA_1 | H100 | — |
US_ILLINOIS_2 | A100 80GB | — |
EU_FRANKFURT_1 | H100 | — |
EU_ICELAND_1 | H200 | — |
EU_ICELAND_2 | B200 / H200 | — |
AP_TOKYO_1 / _2 | H100 / H200 | — |
AP_NEWSOUTHWALES_1 | B200 | — |
NA_BRITISHCOLUMBIA_1 / _3 | B300 | — |
NA_BRITISHCOLUMBIA_2 | AMD MI350X 288GB | — |
US_ARIZONA_3 / US_CALIFORNIA_2 / US_NEWYORK_1 | AMD MI325X 256GB | — |
Fireworks Sovereign (Enterprise Private Preview)
El mismo motor de serving en GPU propias / ya contratadas del cliente; el cliente conserva arquitectura y política; Fireworks hace calificación, deploy, upgrade, monitorización y respuesta a incidentes.
Sovereign equivale a BYOC gestionado; Airgap es el SKU de aislamiento más duro.
| Sovereign / BYOC | Airgapped EKS | |
|---|---|---|
| Plano de control | Fireworks opera el stack de serving; el cliente conserva cuenta cloud / K8s / GPU / red | Sin metadatos de vuelta al plano de control de Fireworks |
Consola / firectl | Misma API / SDK; un endpoint global entre clústeres Sovereign | Consola web o firectl remoto no disponible |
| Red | Plano de control alcanzable; lista blanca de egress | Registry privado + S3 interno + Helm; aterrizaje en cuatro fases |
| Training | Preview no abierto (coming soon) | Inferencia aislada primero |
| Desbordamiento híbrido | Puede abrirse a Fireworks Cloud | Air-gap por defecto, sin desbordamiento |
| Quién | Ya tiene GPU, quiere K8s de producción, utilización o residencia/compliance | Aislamiento duro, los metadatos no pueden salir |
Módulo 2: Training
Las empresas llamaban directamente a modelos generales cerrados gigantes como Claude Opus o GPT-5/6. Ahora usan Fireworks para afinar / RL un modelo abierto de tamaño medio (p. ej. 30B Muse Glimmer o GLM 5.3 Flash) sobre un solo trabajo interno y ponerlo en producción: más pequeño, más especializado, el coste de inferencia cae en picado, baja la latencia. Como train y serve están en la misma plataforma (sin exportar cientos de GB de pesos a un segundo clúster), la iteración de semanas pasa a horas.
- Cursor (Federico Cassano): la asignación de recursos de una compañía AI native — los mejores ingenieros de algoritmos deben escribir entornos sandbox de código (Environment) y funciones de recompensa (Reward), no kernels CUDA ni clústeres GPU.
- Vercel (Malte Ubl): por qué Compound AI — la herramienta de generación front-end
v0no es un modelo gigante para todo, sino router + codegen + un modelo pequeño Auto-fix; las bases rotan cada semana, y con Fireworks una Recipe puede moverse a la última base abierta SOTA. - Genspark (Kay Zhu): de alquilar una API a poseer los pesos cierra el bucle en 4 semanas.
Cualquier entrenamiento (sobre todo RL) tiene dos movimientos — ① Rollout / Sample (correr trayectorias: el modelo responde o llama herramientas) y ② Train (actualizar: puntuar, gradiente, pesos). Fireworks ofrece cuatro caminos según quién escribe el Loop y cómo se usan las GPU.
| Camino | Quién escribe el Loop | Métodos | Programación / facturación | Para quién |
|---|---|---|---|---|
| Managed Training | Plataforma | SFT, DPO, ORPO. FAQ del producto: LoRA only; la página de precios sigue listando tramos Full SFT/DPO | Automático de plataforma; por training token | Ingenieros ML sin pila de entrenamiento |
| Serverless Training API | Equipo de algoritmos del cliente | SFT / alineación de preferencia / RL / destilación / loss custom; solo LoRA | Piscina compartida, sin GPU ociosa; por Prefill / Sample / Train token | Iterar RL rápido en Python |
| Dedicated Training API | Equipo de algoritmos del cliente | Lo anterior + pesos completos / MoE gigante / destilación teacher-student | Trainer + Sampler reservados; por GPU-hora | Escala, aislamiento, control de forma |
| RL Rollouts Only | Trainer propio del cliente | Hot-load de checkpoints en inferencia para Rollout | Tarifa de GPU desplegada | Equipos que ya tienen trainer |
Resultados de entrenamiento
| Cliente | Base / método | Resultado público |
|---|---|---|
| Harvey Tenet | Kimi K3 + async RL | LAB all-pass 19.7% vs base 10.8%; Contracts 11.3% vs 9.3%; $5.92 vs $5.62 por tarea. Decenas de miles de trazas >50 turn / 100K generated-token por checkpoint. |
| Vercel v0 Auto Fix | RFT + speculative decoding | 93% error-free generation; latencia extremo a extremo 40× frente al modelo cerrado que sustituyó; compile-pass de Sonnet 3.5 62% vs «90s» |
| Heidi Evidence | Nemotron 3 Ultra 550B: Managed SFT → Training API RL → NVFP4 Dedicated | A/B en vivo vs un scribe clínico frontier de producción ~54% win (base ~42%); POC→producción en 4 semanas; latencia ~3.5× mejor |
| Factory | Dos LoRA pequeños en Qwen (marcas de fuga / recorte de falsos positivos) | Con presupuesto de 5% de falsos positivos, ~70% de fugas reales vs GPT-5.5 ~59% |
| Kalshi cookbook | Muse Glimmer 30B, un SFT | Accuracy en topic no visto 58.3% vs Jev 47.1%, base 53.2%; backtest $1,000 → $1,071 (Jev y la base perdieron dinero) |
Módulo 3: Fireworks Lab
Fireworks Lab es un embed de alto ARPU y bajo COGS de GPU para bloquear el presupuesto núcleo de un gran cliente y dejar evaluadores y loops de entrenamiento. Las GPU se facturan en los SKU públicos del Módulo 2 Training / Módulo 5 Inference; Lab factura tiempo de investigador.
Entrega por proyecto: el cliente conserva modelo, eval harness, tuberías de datos, loop de entrenamiento y recipes — cuando la base se fortalece, el estándar se mueve con ella. Embed de alto ARPU y bajo COGS de GPU para bloquear el presupuesto núcleo de un gran cliente y dejar evaluadores y loops de entrenamiento.
- Ciclo de unos 6–10 semanas, un time-boxed build contado hacia atrás desde una fecha. (Genspark Deep Research, Heidi clinical scribe).
- Apertura diagnosis: capacidad, baseline, criterios de éxito, alcance.
- Paquetes de trabajo (página Training «We build with you»):
- Data readiness: derechos, volumen, si sirve para producción; confirmar «podemos ganar antes de gastar más».
- Eval design: escribir evals con los expertos del cliente; poner modelos propios y ajenos en la misma regla.
- Training strategy: base, método, economía de serving, reentrenar con nuevas traces / una nueva base.
- Comparte la misma pila train-serve que el Módulo 2 Training; Lab vende tiempo de investigador y método, no un SKU de GPU. Si faltan algoritmos, Lab es la capa de servicio encima de Managed / Training API.
| Cliente / artefacto | Base y método |
|---|---|
| Harvey Tenet (2026-08) | Kimi K3 + async RL (Training API) |
| Genspark Gen-1 Slides (2026-09) | MiniMax M3: primero SFT, luego RL más largo por etapas |
| Genspark Deep Research (2025-10) | Kimi K2 1T + RFT, B200 |
| Heidi Evidence (2026-10) | Nemotron 3 Ultra 550B: Managed SFT (trazas sintéticas de agent) → Training API RL → NVFP4 Dedicated / Blackwell |
| Kalshi / Glimmer cookbook | Muse Glimmer 30B, un LoRA SFT |
| Notion | Fine-tune + inferencia |
| Vercel v0 | RFT + speculative decoding |
Módulo 4: Models
El suministro de modelos son tres carriles:
- Fireworks models (propios)
- Model library (laboratorios abiertos)
- Your models (pesos del cliente)
Fireworks models (propios)
Ember-1 es un especialista de razonamiento corto sobre Kimi K3. Motivo: K3 a veces gasta >90% de los tokens generados en razonamiento interno; los agents multi-turno reinyectan ese reasoning y el contexto crece casi al cuadrado; bajar el effort de K3 pierde calidad. El equipo corrió 50+ experimentos de Serverless Training y 200+ evals, sin datos de clientes.
Línea externa: unos 40% menos tokens, calidad cercana a K3; en cinco benchmarks de industria a ~1 punto de Claude Opus 5, ~1/5 del coste por tarea (marketing / eval interna). En Doximity Bedside Bench (500 casos clínicos / 10 especialidades) se sitúa en la frontera de Pareto coste/tarea frente a GPT-5.6 Sol, GPT-6 Astra y Claude Opus 5.
Tabla pública de comparación (autotest de la compañía)
| Benchmark | N | K3 max | Ember-1 |
|---|---|---|---|
| Terminal Bench 2.1 | 89 | 80.9% | 82.0% |
| SWE-bench Verified | 500 | 93.2% | 92.2% |
| SWE-Interact | 75 | 21.3% | 20.0% |
| DeepSWE 1.1 | 113 | 66.4% | 75.2% |
| τ-2 Bench Airline | 50 | 64% | 66% |
Dos A/B de coding en producción: unos -35% tokens / tarea, calidad plana; uno ya cortó. Tráfico interno: los desarrolladores no notaron el cambio. Una tabla interna también da reasoning tokens -71.3%, output 49.3K → 29.9K, score 0.751 → 0.753. Ahora es Research Preview: los modelos de investigación nuevos tienen dos semanas de Serverless y luego gradúan según demanda de la comunidad. El entrenamiento de Ember-1 está abierto; el cliente puede especializar más. Serverless y Dedicated lo sirven.
Model library
Selección de modelos abiertos por escena
| Escena | Representantes oficiales |
|---|---|
| Código / Agent | DeepSeek V4.1 Flash 1017, Kimi K3.1 Pro, GLM 5.3, MiniMax M3 |
| Contexto largo | DeepSeek V4.1 Flash 1017, Kimi K3.1 Pro, Qwen 3.7 Plus, GLM 5.3 |
| Vision / documentos | Kimi K3.1 Pro, DeepSeek V4.1 Flash 1017, Qwen 3.7 Plus, Step 3.7 Flash, Gemma 4 31B |
| Audio / Video | Qwen3 Omni 30B A3B Instruct, Nemotron 3 Nano Omni 30B A3B; GLM 5.3 Flash admite vídeo Serverless |
| Embeddings / Rerank | Qwen3 Embedding 8B, Qwen3 Reranker 8B; MiniLM / BGE / nomic no están en la vista principal de Library pero siguen llamables en Serverless |
| Decisiones de baja latencia | Rune 26B-A4B (solo input) |
Suministro cerrado frente a sustitutos abiertos
| Cerrado | Presupuesto de latencia | Sustituto abierto |
|---|---|---|
| Claude Opus 4.8 / Sonnet 4.6; GPT-5.5 / Pro; Gemini 3.1 Pro | High (calidad primero) | DeepSeek V4.1 Flash 1017, Kimi K3.1 Pro, GLM 5.3, MiniMax M3, Qwen 3.7 Plus |
| Claude Haiku 4.5; GPT-5.4 mini/nano; Gemini 3.5 Flash / 3.1 Flash-Lite | Low (velocidad primero) | Step 3.7 Flash, DeepSeek V4.1 Flash 1017, MiniMax M3, Qwen3 8B |
Your models (pesos del cliente)
- La salida del entrenamiento es 100% del cliente, sujeta a la licencia de la base;
firectl model downloadexporta Hugging Face PEFT; también se pueden subir adapters / pesos custom compatibles. - Un solo LoRA puede live-merge en la base, velocidad cercana a la base; Multi-LoRA unos 100 addons comparten un Dedicated.
- Specialized Model Inference (Public Preview, Forge 2026): cuelga LoRA en Serverless compartido, al precio token de la base, sin GPU ociosa. Hoy solo
GLM 5.3 Flash(accounts/fireworks/models/glm-5p3-flash), como máximo 3 adapters por base, rank ≤ 64; el cuarto devuelveResourceExhausted. Flujo: Train/import → Load < 5 minutos → la primera petición < 1 minuto deja el LoRA en cache → después latencia cercana a la base. Requiere firectl ≥ 1.8.15. Las demás bases siguen necesitando Dedicated. <a href="https://docs.fireworks.ai/serverless/specialized-model-inference/overview.md">https://docs.fireworks.ai/serverless/specialized-model-inference/overview.md</a>
Precios
| Modelo | Input | Cached | Output |
|---|---|---|---|
| Ember-1 / Kimi K3 | $3.00 | $0.30 | $15.00 |
| Kimi K3 (US) | $4.50 | $0.45 | $22.50 |
| Qwen 3.8 Max | $2.00 | $0.25 | $6.00 |
| GLM 5.3 | $1.40 | $0.26 | $4.40 |
| GLM 5.3 (US) | $2.10 | $0.39 | $6.60 |
| Muse Spark Open | $1.25 | $0.15 | $4.25 |
| Nemotron 3 Ultra (Preview) | $0.60 | $0.12 | $2.40 |
| DeepSeek V4.1 Flash / 1017 | $0.30 | $0.006 | $1.20 |
| DeepSeek V4.1 Flash / 1017 (US) | $0.45 | $0.009 | $1.80 |
| MiniMax M3 | $0.30 | $0.06 | $1.20 |
| GLM 5.3 Flash / Ultramarine 1 Flash (US) | $0.15 | $0.03 | $0.50 |
| GLM 5.3 Flash (US) | $0.225 | $0.045 | $0.75 |
| GPT OSS 120B / MiniMax M3.1 Flash | $0.15 | $0.015 | $0.60 |
| Nemotron 3.5 Lightning 30B A3B | $0.05 | $0.01 | $0.20 |
| Rune 26B-A4B | $0.042 | $0.0084 | $0 |
Módulo 5: Inference
Los productos de inferencia, según crece el tráfico, son tres rampas: Serverless (coche compartido de tokens) → Reserved Throughput (dólares por minuto para sostener el SLA) → Dedicated / GPU Reserve (alquilar tarjetas enteras por segundo / por año).
- Serverless: piscina multi-tenant, sin cold start, sin selector de GPU. Compatible OpenAI y Anthropic, por token.
- Reserved Throughput (Serverless SLA): se compra cuota en dólares/minuto, use-it-or-lose-it por minuto, no se acumula. La página de precios escribe throughput SLA + 99.9% uptime terms (los docs solo escriben throughput SLA; el texto completo de créditos no es público).
- GPU Reserve / Reserved capacity: típico empresarial 1 año; capacidad garantizada, cuotas más altas, GPU-hora más baja, regiones Pre-GA / silicio nuevo.
| Mode | Cómo elegir | Uso | Señal de precio | Notas |
|---|---|---|---|---|
| Standard | Por defecto, sin service_tier | Producción online | Lista | TPM adaptativo |
| Priority | service_tier: "priority" | Menos 503 load-shed en pico | La mayoría ~+25%; Qwen 3.8 Max / MiniMax M3 a 1.5× | Comparte el mismo TPM que Standard; solo prioridad de scheduling |
| Fast | Cambiar model ID, p. ej. .../routers/kimi-k3-fast, glm-5p3-fast | Interactivo; 100+ tok/s declarado | Kimi K3 Fast $4.50 / $0.45 / $22.50; GLM 5.3 Fast $2.10 / $0.39 / $6.60 | Calidad igual; cubo de rate independiente |
| Ultra-fast (Preview) | .../deepseek-v4p1-flash-1017-ultrafast | Latencia extrema | $2.40 / $0.048 / $9.60 (unos 8× Standard) | Blackwell; demo Forge de DeepSeek V4.1 Flash hasta ~1.500 tok/s; agent de 30 turnos 1 min → 8 s. Independiente, rate más apretado |
| Batch | Trabajos Batch API | Async offline | Input+Output ambos 50% | JSONL hasta 80 GiB; prompt cache automático |
| Spot | Model ID independiente (*-spot) | Mejor esfuerzo | Unos Standard -30% | El throughput puede ir a 0; 503/429; la plataforma no cae sola a Standard, el cliente cambia el ID. Hoy GLM-5.3 / Kimi K3 / DeepSeek V4.1 Flash / 1017 |
Módulo 6: Model ensembling (Nexus + API)
Dos caras: la herramienta humana (Fireworks Nexus) y la API de sistema (Fireworks API). Línea de producto: conservar ChatGPT / Claude / el harness de código; los turnos cotidianos van abiertos, los más duros cerrados; factura de equipo −50%+; en la API «cambiar una base URL», compatible OpenAI / Anthropic. El FAQ de Nexus es explícito: no es solo un LLM router — CLI más tools, Auto por turno, Settings con presupuesto; las tres juntas hacen una «organización multi-modelo».
Nexus Auto
Cerrado + abierto juntos con Nexus: para que el desarrollador siga usando Claude Opus y GPT dentro de Claude Code, Cursor u OpenCode, Fireworks usa un pass-through cliente/pasarela en Nexus (antes FireRouter) — pones tu propia Key de Anthropic/OpenAI; los turnos duros van a los servidores oficiales; los rutinarios a modelos abiertos o Ember-1 / Qwen Plus en las salas de Fireworks. Así un proveedor de cómputo se mantiene del lado correcto de los términos de modelos cerrados y recorta más del 50% de la factura cerrada.
| Pro | Team | Enterprise | |
|---|---|---|---|
| Quién | Individuo | Equipo con factura compartida | Empresa que necesita plano de control |
| Precio de lista | $8 / mes | $10 / asiento / mes | Uso, hablar con ventas |
| Asientos | 1 | Hasta 200, el admin compra e invita | Ilimitados |
| Uso | Cuota incluida, ventana rodante + reset mensual | Cuota por asiento mayor que Pro | Pagas lo que usas |
| Modelos | Nexus Auto + Claude / ChatGPT propios | Igual que Pro | Igual que Team, más elección directa de modelos abiertos Serverless de Fireworks (p. ej. glm-latest) |
| Datos | Zero Data Retention en todos los planes | Igual | Igual |
| Admin | Model Providers | Miembros / asientos / Providers | Spend Limits, SSO, SCIM, Model access, Data residency, Audit |
Fireworks API (cara de sistema)
Fireworks API (cara de sistema) es esencialmente la Serverless Inference API ya despiezada arriba (más los Routers / interfaces de deploy).
Frente a OpenRouter
En superficie, Fireworks Nexus y OpenRouter entran en «acceso unificado multi-modelo y routing inteligente (Model Routing)» y ambos enchufan Cursor, Claude Code, OpenCode; el modelo de negocio, la lógica de routing y el lugar en la cadena son distintos — y en la cadena de cómputo, Fireworks es uno de los proveedores upstream de inferencia abierta más importantes de OpenRouter.
- OpenRouter es un «bazar neutral de agregación de modelos (marketplace B2D horizontal)»: el trabajo es «encontrar un modelo entre proveedores, comparar precio, failover». No cría flota; hace pasarela unificada y cobra recargas o spread mayorista.
- Fireworks Nexus es un «add-on de recorte de coste de agent atado a su propio motor (embudo de integración vertical)»: el trabajo es «sin cambiar el hábito de Claude Code / Cursor / OpenCode, descargar el 70% de las tareas rutinarias de los modelos cerrados caros a los abiertos de Fireworks, por turno», para llenar sus propios motores Serverless/Dedicated de alto margen.
- Cuando el desarrollador corre
nexus claudeonexus codex, la herramienta conserva el login de Claude o la API Key propia de OpenAI/Anthropic (las claves se quedan en el llavero local, no se suben) - La empresa no tiene que tirar contratos Anthropic/OpenAI ni suscripciones de escritorio ChatGPT/Claude, y puede estirar 2 a 3× un presupuesto anual de AI que de otro modo se quema en 4 meses (el dolor de ingeniería de Uber en textos públicos).
- Cuando el desarrollador corre
Foso de ingeniería
Las nubes tempranas de modelos abiertos alquilaron GPU bare metal y envolvieron vLLM/SGLang open source, y cayeron en una guerra de precios homogeneizada. La tesis de Fireworks para sostener margen bruto y trabar el 95%+ de tráfico de modelos a medida es que cerró tres fallas industriales:
- Cerrar la falla de «sesgo numérico train–serve»: En post-entrenamiento y RL de MoE gigantes (Kimi K3, DeepSeek V4.1), el camino clásico entrena en Megatron/FSDP a BF16 y exporta a vLLM a FP8/FP4. Diferencias de operadores, redondeo de baja precisión y el router MoE activando expertos distintos bajo ruido mínimo producen «curva de reward arriba en entrenamiento, colapso de accuracy en producción». Fireworks construyó un kernel train-serve idéntico (FireAttention), alineado nativamente a BF16, block FP8 y NVFP4 de NVIDIA, y MoE Router Replay, forzando backprop y sampling por el mismo camino de expertos, con KL serve-vs-train en KLD < 0.007 (rechazo de token < 3%).
- Cerrar la falla de «GPU ociosa en RL asíncrono»: En 2026 el paradigma empresarial de modelos a medida pasó de SFT estático a Agentic RL / RFT. En el loop, el 70%–85% del tiempo GPU es Rollout (muestrear Trajectory enormes en código o tools), no el paso de gradiente. Si train y serve están separados, sincronizar un Checkpoint de cientos de GB deja GPU esperando. RL Rollouts y Serverless Training API usan arquitectura async; Delta-compressed Weight Updates envían ~2% del cambio de pesos, con prefetch de fondo, para hot-swap de memoria GPU sub-minuto (< 1 minuto), declarado a 10.000+ GPU de RL concurrente.
- Cerrar la falla de «coste de contexto largo de agent multi-turno» (Session Affinity + Nexus): Un trabajo de coding agent suele cruzar decenas de turnos, contexto a 100K–1M tokens. Fireworks implementa Session Affinity en el scheduler, clavando las peticiones consecutivas de una sesión Agent al nodo que ya tiene su KV Cache, hit declarado hasta 99.6% (sin fee de escritura de cache; lecturas a mitad de precio o menos). En el terminal, Nexus como «router consciente de dificultad y cache» descarga búsqueda de archivos, reescrituras ordinarias y tests — más del 70% del desarrollo diario — a modelos abiertos rápidos de Fireworks, y solo el razonamiento de arquitectura más duro pasa a una API cerrada, recortando la factura de coding AI 50%–72%.
| Capa de monetización | Vehículo de producto | Medidor | Rol comercial y estructura de margen |
|---|---|---|---|
| Capa 1: adquisición de alta frecuencia y relleno de valle | Serverless Inference (Standard / Batch / Spot) + turnos abiertos de Nexus | Por token ($0.05–$15.00 / 1M); Batch 50%, Spot ~70% | Bin-packing: llenar valles GPU con jobs async e interrumpibles de 10.000+ clientes. Nexus $8/$10 es cuña de adquisición y gobierno; los tokens se miden en esta capa. |
| Capa 2: vaca de spread PaaS | On-Demand Dedicated / Reserved / RL Rollouts / Dedicated Training | GPU-segundo ($8–$20/h) o $/min reservado | Prima de software: mayorista H100 1–3 años Norteamérica ~$2–$3/h; tras el motor, scale sin cold start y ~100 Multi-LoRA, se vende a $8.00/h (región única $12.00/h). |
| Capa 3: pegajosidad de datos y pesos | Managed Training / Training API / Evaluators / Your models | Tokens train/sample ($0.50–$40 / 1M) | Alto coste de cambio: > 95% de tokens de modelos especializados del cliente. Evals, tuberías RFT y pesos NVFP4, una vez sentados, no se cambian como una API pública. |
| Capa 4: licencia de software puro y servicios de alto ARPU | Fireworks Lab + Sovereign / BYOC + Nexus Enterprise | Contrato anual + asientos/licencia | COGS de GPU cero (o casi): Lab 6–10 semanas embebe y traba presupuesto (Harvey Tenet, Genspark Gen-1, Heidi dejan evals y loops en el cliente); Sovereign/BYOC corre en las salas del cliente, sin depreciación ni electricidad, licencia de motor (línea de marketing: ~$14.5M/año de capacidad extra por 1.000 B300). |
Why Fireworks?
Frente a TSMC
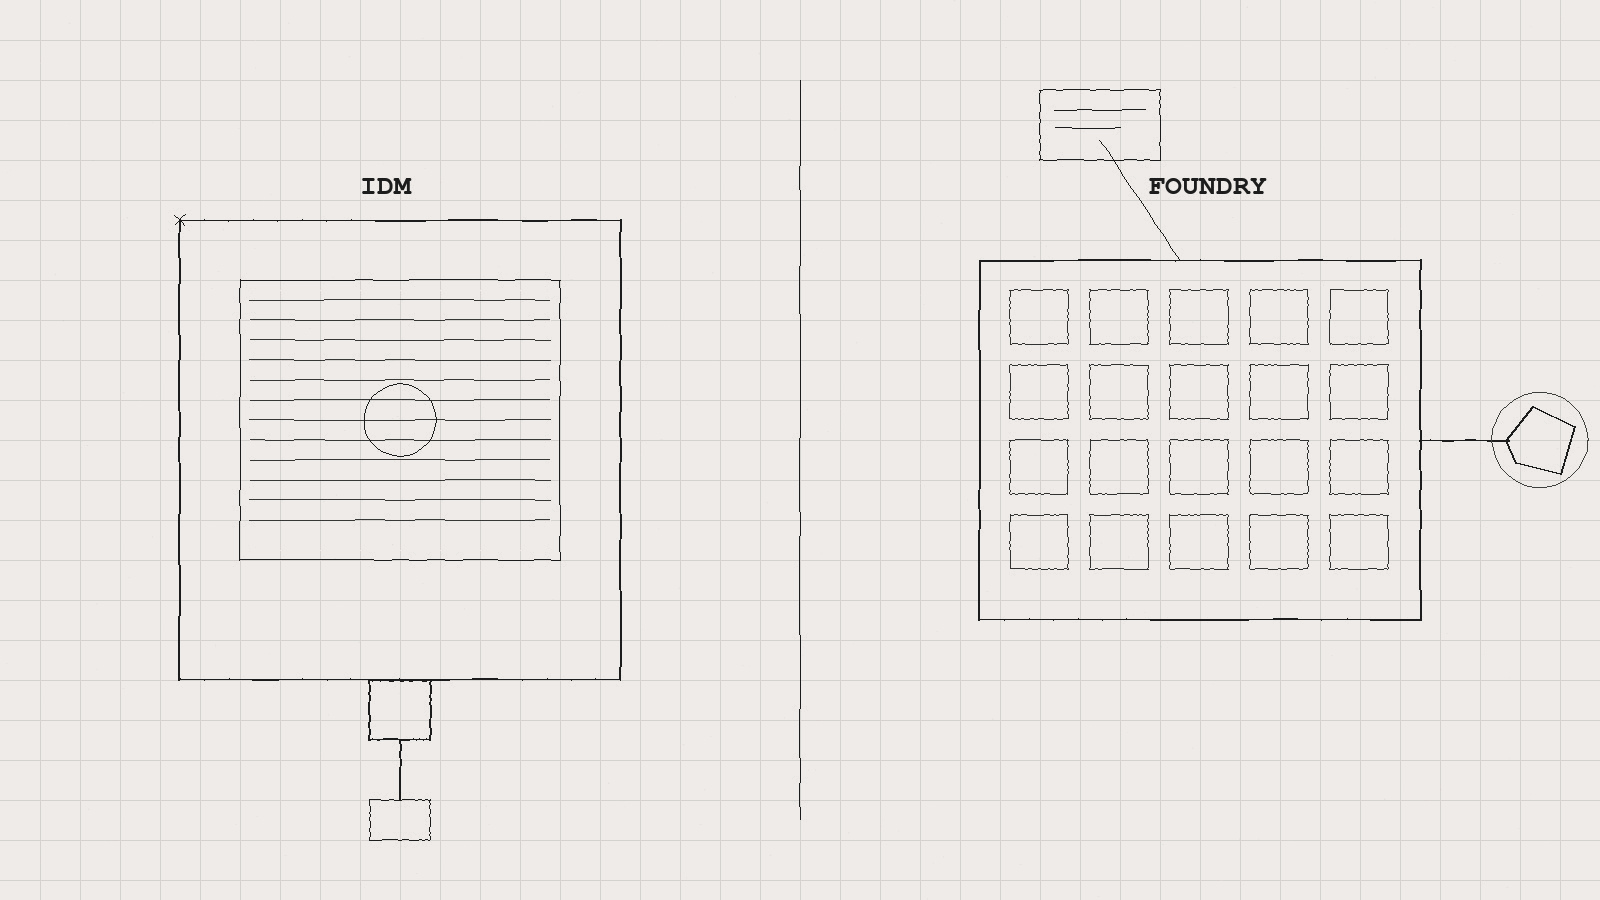
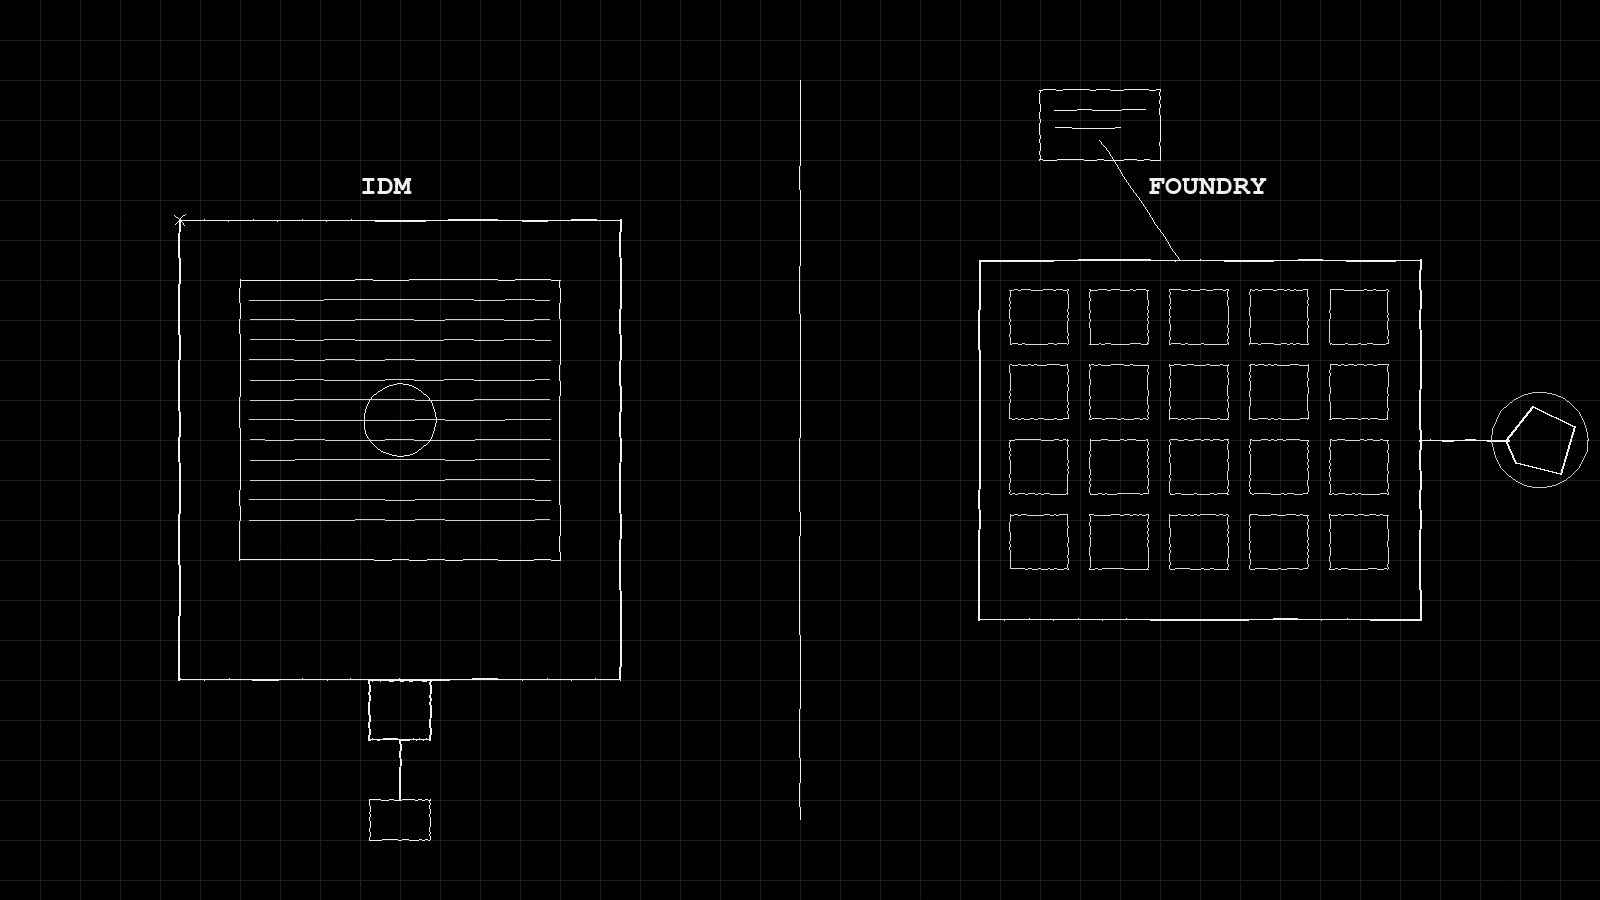
El paso de la industria de semiconductores del monopolio IDM a Fabless (sin diseño de oblea) + Foundry (fabricación especializada).
- IDM temprano ↔ Frontier Lab cerrado (OpenAI / Anthropic): al principio solo un gigante IDM como Intel, diseñaba, fabricaba y vendía piezas con marca Intel. Eso mapea a OpenAI y Anthropic de hoy: preentrenan un modelo general cerrado, lo sirven en clúster interno, venden una API caja negra.
- Auge Fabless ↔ 10.000+ empresas verticales que poseen datos privados: Apple, NVIDIA, AMD, Qualcomm no gastaron cada uno cientos de miles de millones en una fab; dibujaron el chip y lo mandaron a TSMC. En la era AI, Cursor, Harvey, Notion, Uber, Vercel son el Fabless — tienen el workflow, los datos privados verticales y las funciones de recompensa RL (los «dibujos» del modelo especializado), pero no quieren que una API cerrada trabe margen y latencia, ni van a nutrir un equipo de cien personas de kernels CUDA y sistemas distribuidos de 10.000 GPU para poseer una «línea de tokens».
- Nacimiento de Foundry ↔ Fireworks AI: Fireworks es la foundry especializada que toma esos decenas de miles de «dibujos de modelo especializado» y los convierte en flujos de tokens de producción de alto throughput y bajo coste.
Comparación de ingeniería
| Elemento de foundry de semiconductores (TSMC) | Análogo de foundry de fábrica AI (Fireworks AI) | Por qué esto es «TSMC» y no una nube ordinaria |
|---|---|---|
| 1. Herramientas de litografía y obleas (ASML EUV + silicio) | Aceleradores heterogéneos (NVIDIA H200 / B200 / B300 + AMD MI325X) | Un Neocloud ordinario (alquiler bare metal temprano) te entrega el «stepper» para operarlo tú; TSMC/Fireworks vende yield de línea y output acabado. |
| 2. IP estándar y PDK (núcleos públicos Arm + mazos de reglas EDA) | Biblioteca de bases abiertas + toolchain FireOptimizer (DeepSeek / Kimi / Qwen / GLM / Llama + tuberías RFT) | TSMC prealinea núcleos públicos Arm a su proceso; Fireworks termina el bring-up de operadores el Day-0 del modelo abierto y entrega un kit estándar de post-train de SFT a RL. |
| 3. Shrink de nodo y yield de oblea (7nm a 3nm, fugas y scrap) | Quant de baja precisión y yield numérico (BF16 a FP8 / NVFP4, divergencia KL bajo 0.007) | Una fab teme el scrap tras el shrink; la inferencia AI teme que el modelo «se vuelva tonto» o desalinee train-serve tras acelerar con quant. Fireworks sube el throughput 4× y clava KL vs el original bajo 0.007 (rechazo de token bajo 3%). |
| 4. Empaquetado avanzado CoWoS (integración chiplet) (Die de cómputo, Die I/O y HBM en un paquete) | Empaquetado Compound AI (routing Nexus + decode especulativo adaptativo + Multi-LoRA) | Cuando un modelo gigante es demasiado caro, Fireworks «empaqueta» un draft pequeño, cien LoRA, especialistas abiertos y modelos cerrados en un mismo tubo de serve. |
| 5. Ley de hierro comercial: nunca competir con el cliente (nunca diseñar chips y vender dispositivos finales) | Ley de hierro estratégica: nunca ser un Frontier Lab cerrado (sin pretrain general cerrado; pesos 100% del cliente) | OpenAI y Google venden API y también apps de consumo y tools de código, un conflicto natural con el cliente aguas abajo; Fireworks se compromete a proceso y foundry; el cliente puede exportar pesos en cualquier momento. |
Frente a vLLM y SGLang
Si solo se mira levantar un modelo abierto en una sola caja, continuous batching y memoria paginada, el motor de Fireworks y vLLM (PagedAttention y alto throughput general) y SGLang (RadixAttention de reuso de prefijo y decode JSON estructurado) resuelven de verdad la misma clase de problema.
Pero vLLM/SGLang se detienen en inferencia pura, mientras Fireworks abrió identidad train-serve y RL online.
| Dimensión técnica | vLLM open source | SGLang open source | Pila propia de Fireworks (FireAttention + FireOptimizer) |
|---|---|---|---|
| Trabajo núcleo | Motor abierto de inferencia de alto throughput (ecosistema más amplio, soporte Day-1 más completo) | Motor abierto para agents multi-turno, reuso pesado de prefijo y salida estructurada | Base comercial de «fábrica AI» con train-serve en uno (kernels CUDA hasta el loop RL) |
| Atención y memoria | PagedAttention (KV Cache paginado, mata fragmentación) | RadixAttention (árbol radix reusa KV de prefijo compartido) | FireAttention V1–V3: CUDA/PTX a mano para Hopper/Blackwell (NVFP4)/MI300 + atención intercalada a trozos para contexto muy largo |
| Quant y precisión | FP8/INT8/INT4/AWQ/GPTQ, el usuario afina y verifica | FP8/INT4/AWQ mainstream, igual el usuario verifica la pérdida | FireOptimizer quant con puerta: calibración fina BF16/FP8/NVFP4, KLD bajo 0.007, rechazo de token bajo 3% |
| Decode especulativo | Draft genérico, Medusa, EAGLE, N-gram (config estática) | EAGLE-2/3 y drafts genéricos (config estática) | Adaptive Speculative Execution: auto-entrena/evoluciona un draft dedicado sobre el tráfico vivo del cliente, hasta 3x–40x |
| Alcance del cache | Instance / nodo Automatic Prefix Caching | Instance / nodo match de prefijo en árbol radix | Session Affinity de clúster: routing de gateway ligado al estado KV del nodo, piscina multi-tenant medida 99.6% hit |
| Alineación MoE train-serve y RL online | Solo inferencia; necesita trainer externo; fácil deriva MoE | Solo inferencia; a menudo sampler detrás de veRL, sync a mano | Kernel train-serve idéntico + MoE Router Replay + hot-load de 2% delta sub-minuto, RL async nativo a 10k GPU |
| Equipo que mejor encaja | Tiene Infra profesional, quiere control, tráfico mixto o fine-tunes estándar | Tiene Infra, workflows agent multi-turno pesados o extract JSON de alta frecuencia | Quiere latencia de primer token/throughput extremos y RFT/RL a medida de alta frecuencia, no quiere nutrir un gran equipo de kernels y flota |